Eingebaute Tippfehler: vier OCR-Engines, 16 Bilder mit Text
Wir haben 20 Testbilder gemacht. 12 generierte mit einem Markennamen darauf, die meisten mit einem absichtlich eingebauten Tippfehler: zwei Buchstaben vertauscht, einer verdoppelt. Dazu 8 echte Produktfotos. Auf 16 der 20 steht Text.
Vier Engines mussten diesen Text exakt abschreiben, mit einem Prompt, der in Großbuchstaben sagt, dass nichts korrigiert werden darf.
Gemma 4, ein kleines Vision-Modell, das kostenlos auf einem Laptop läuft, kam auf 11 von 16. In 4 Fällen gab es den Markennamen richtig geschrieben zurück, obwohl im Bild der Tippfehler stand. Es hat diese Bilder nicht falsch gelesen. Es hat sie korrigiert. Diese vier Fehler wären veröffentlicht worden.
Warum Vision-Language-Modelle Tippfehler korrigieren
Vision-Language-Modelle sind darauf trainiert, hilfreich zu sein. Sie sagen den wahrscheinlichsten Text für das voraus, was sie sehen, und ein bekannter Name in richtiger Schreibweise ist viel wahrscheinlicher als derselbe Name mit zwei vertauschten Buchstaben. Je besser das Modell das Wort kennt, desto stärker zieht es zur richtigen Schreibweise.
Klassische OCR weiß nicht, was eine Marke ist. Sie kennt nur die Formen von Buchstaben und meldet, was in den Pixeln steht, Fehler inklusive. Um ein Bild zu beschreiben, ist das eine Schwäche. Für eine Rechtschreibprüfung ist es genau der Punkt. Eine hilfsbereite OCR ist eine kaputte OCR.
Klassische OCR plus exakter Abgleich mit dem Briefing
Langweilige OCR liest. Ihr Text wird Buchstabe für Buchstabe mit dem Briefing verglichen. Passt es, geht das Bild raus. Passt es nicht, wird es neu generiert. Das Vision-Modell hat weiter einen Job, Layout und Kontext, aber bei der Schreibweise nie das letzte Wort. Wenn es widerspricht, schaut ein Mensch hin.
Fürs Protokoll: PaddleOCR kam auf 15 von 16 und hat nichts erfunden. Apple Vision kam auf 13 von 16 und hat nichts erfunden. Claude Opus 4.7 kam auf 15 von 16 und hat trotzdem einmal etwas erfunden. Die jahrzehntealte, langweilige Technik hat kein einziges Mal gelogen.
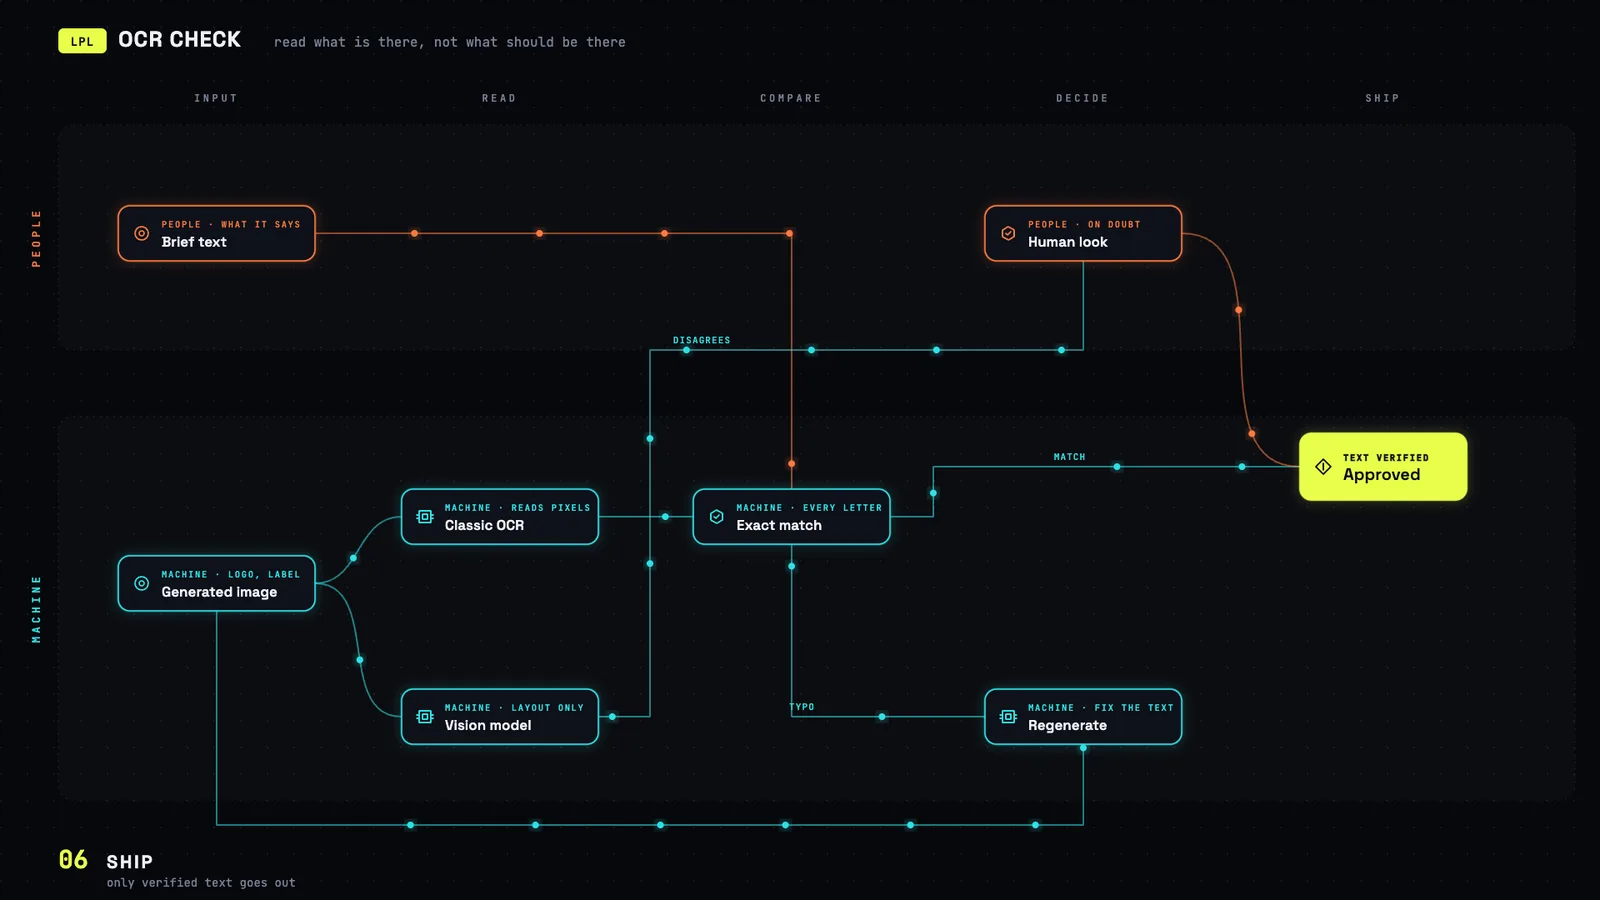 Volle Größe ↗
Wenn Sie ein Vision-Modell zum Lesen nutzen müssen, ist das der Prompt aus unserem Test. Er hilft. Er reicht nicht:
You are a strict OCR engine. Transcribe EVERY visible text string in this image exactly as it appears, character by character. Do not correct any spelling. Do not interpret. If text is misspelled, output it misspelled. Return ONLY a JSON object: {"texts": ["string1", "string2", ...]}. If no text is visible, return {"texts": []}.Und die klassische OCR, die wir stattdessen nutzen. Kostenlos, lokal, ein paar Zeilen Python:
# pip install paddleocr   (first run downloads the models)
from paddleocr import PaddleOCR

ocr = PaddleOCR(use_textline_orientation=True, lang="en")
for page in ocr.predict("image.png"):
    print(page["rec_texts"])   # exactly what is in the pixels, typos included
Text auf generierten Bildern prüfen: unsere Faustregel
Wenn ein generiertes Produktbild, Etikett oder eine Anzeige Text trägt, muss jemand diesen Text prüfen. Ihn mit derselben Art Modell zu prüfen, die den Fehler gemacht hat, ist die Falle. Es sieht, was dort stehen sollte. Sie brauchen etwas, das nur sieht, was dort steht.
Unsere Faustregel inzwischen:
- Pixel lesen: klassische OCR.
- Mit der Wahrheit abgleichen: das Briefing, Buchstabe für Buchstabe.
- Vision-Modelle: beschreiben, sortieren, Layout. Nicht lesen.
16 Bilder sind ein kleiner Test, die Zahlen zeigen also eine Richtung, keinen Benchmark. Die Richtung war klar genug, dass wir unseren eigenen QA-Layer umgebaut haben.