Ein echter Sneaker und ein Datenblatt mit 17 Punkten
Der Schuh ist ein lila Mid-Top-Sneaker einer großen Sportmarke. Ich besitze ein Paar, und das ist wichtig: Jede Zahl in diesem Beitrag wurde am echten Schuh geprüft, nicht an meiner Erinnerung daran.
Das Ziel war ein Bild, das ein Shop oder eine Kampagne wirklich nutzen würde: eine Person trägt das Paar, nahe Seitenansicht, goldenes Abendlicht auf einer Stadtstraße. Als Referenz dienten die Produktfotos der Marke aus neun Blickwinkeln. Sie blieben auf unserem Rechner und sind nicht in diesem Beitrag. Jedes Bild hier ist generiert.
Bevor wir etwas generiert haben, haben wir den Schuh als Datenblatt aufgeschrieben: jedes Teil, das ein Käufer prüfen könnte, und wo es im Verhältnis zu einem anderen Teil sitzt. Auf welcher Seite jedes Logo sitzt. Fünf Schnürösen pro Seite. 15 Löcher im Seitenpanel, in Reihen zu 5, 6 und 4 von oben. Neun erhabene Punkte am Fersenkäfig. Der genaue Text auf dem runden Badge. Am Ende 17 Punkte.
Die Bewertungsregel war streng. Ein Mensch vergleicht jedes Teil in einem engen Ausschnitt mit demselben Teil des echten Schuhs. Ein verdecktes oder zu unscharfes Teil gilt als unsicher, nie als bestanden. Modelle helfen, die Stellen zu finden, aber das letzte Wort haben sie nicht.
Runde eins: das Logo auf der Zunge, das Seitenlogo weg
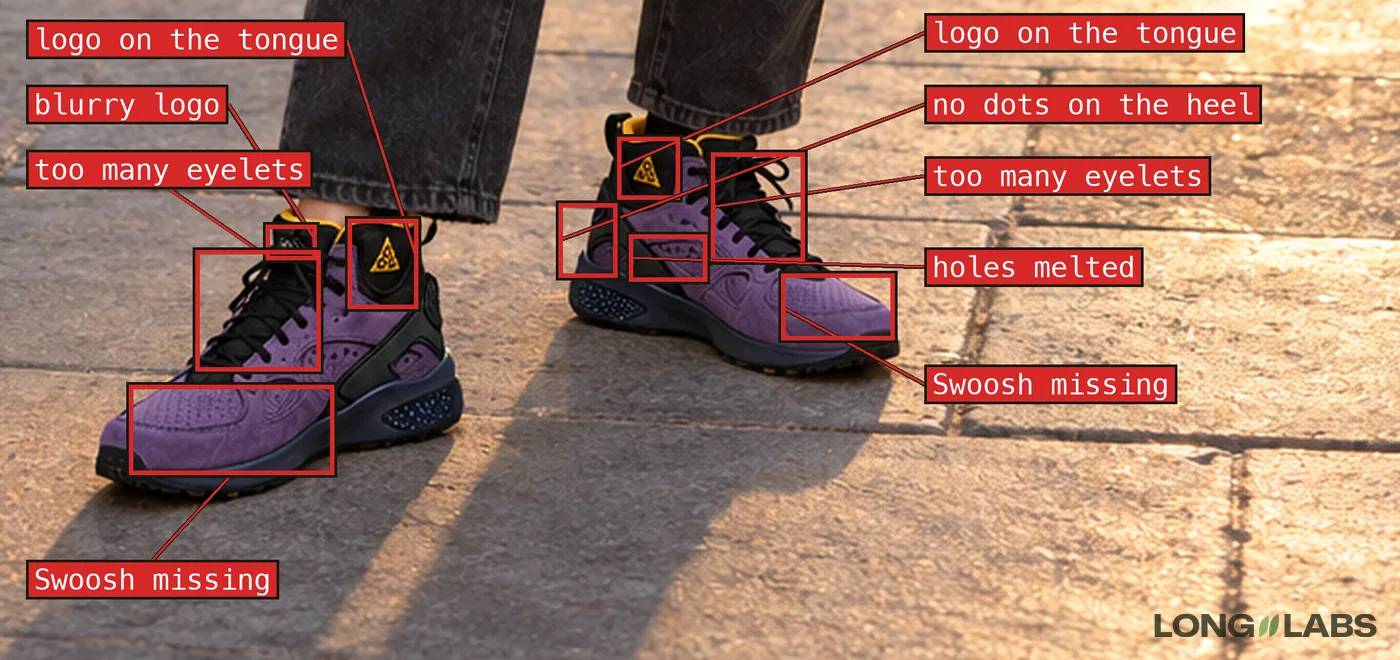
Runde eins nutzte drei Produktfotos und einen vagen Prompt: diese Sneaker, realistisch. In voller Größe sah das Ergebnis gut aus. Dann haben wir hineingezoomt.
Das Dreieckslogo, das auf einem eigenen Patch am Knöchelkragen sitzt, war auf die Zunge gewandert. Das kleine Logo am äußeren Vorfuß fehlte an beiden Schuhen. Aus den flachen Zuglaschen waren Kordelschlaufen geworden, das runde Badge sagte nichts in irgendeiner Sprache, und es gab zu viele Ösen. 7 von 13 sichtbaren Checks bestanden.
Nichts davon sieht man im Vorschaubild. Alles davon sieht jeder, der den Schuh besitzt, und genau diese Leute kaufen ihn am ehesten.
 Volle Größe ↗
Fünf Runden, von 7 von 13 auf 15 von 15 Checks
Jede Runde hat geändert, was hineinging, nicht nur die Formulierung des Prompts.
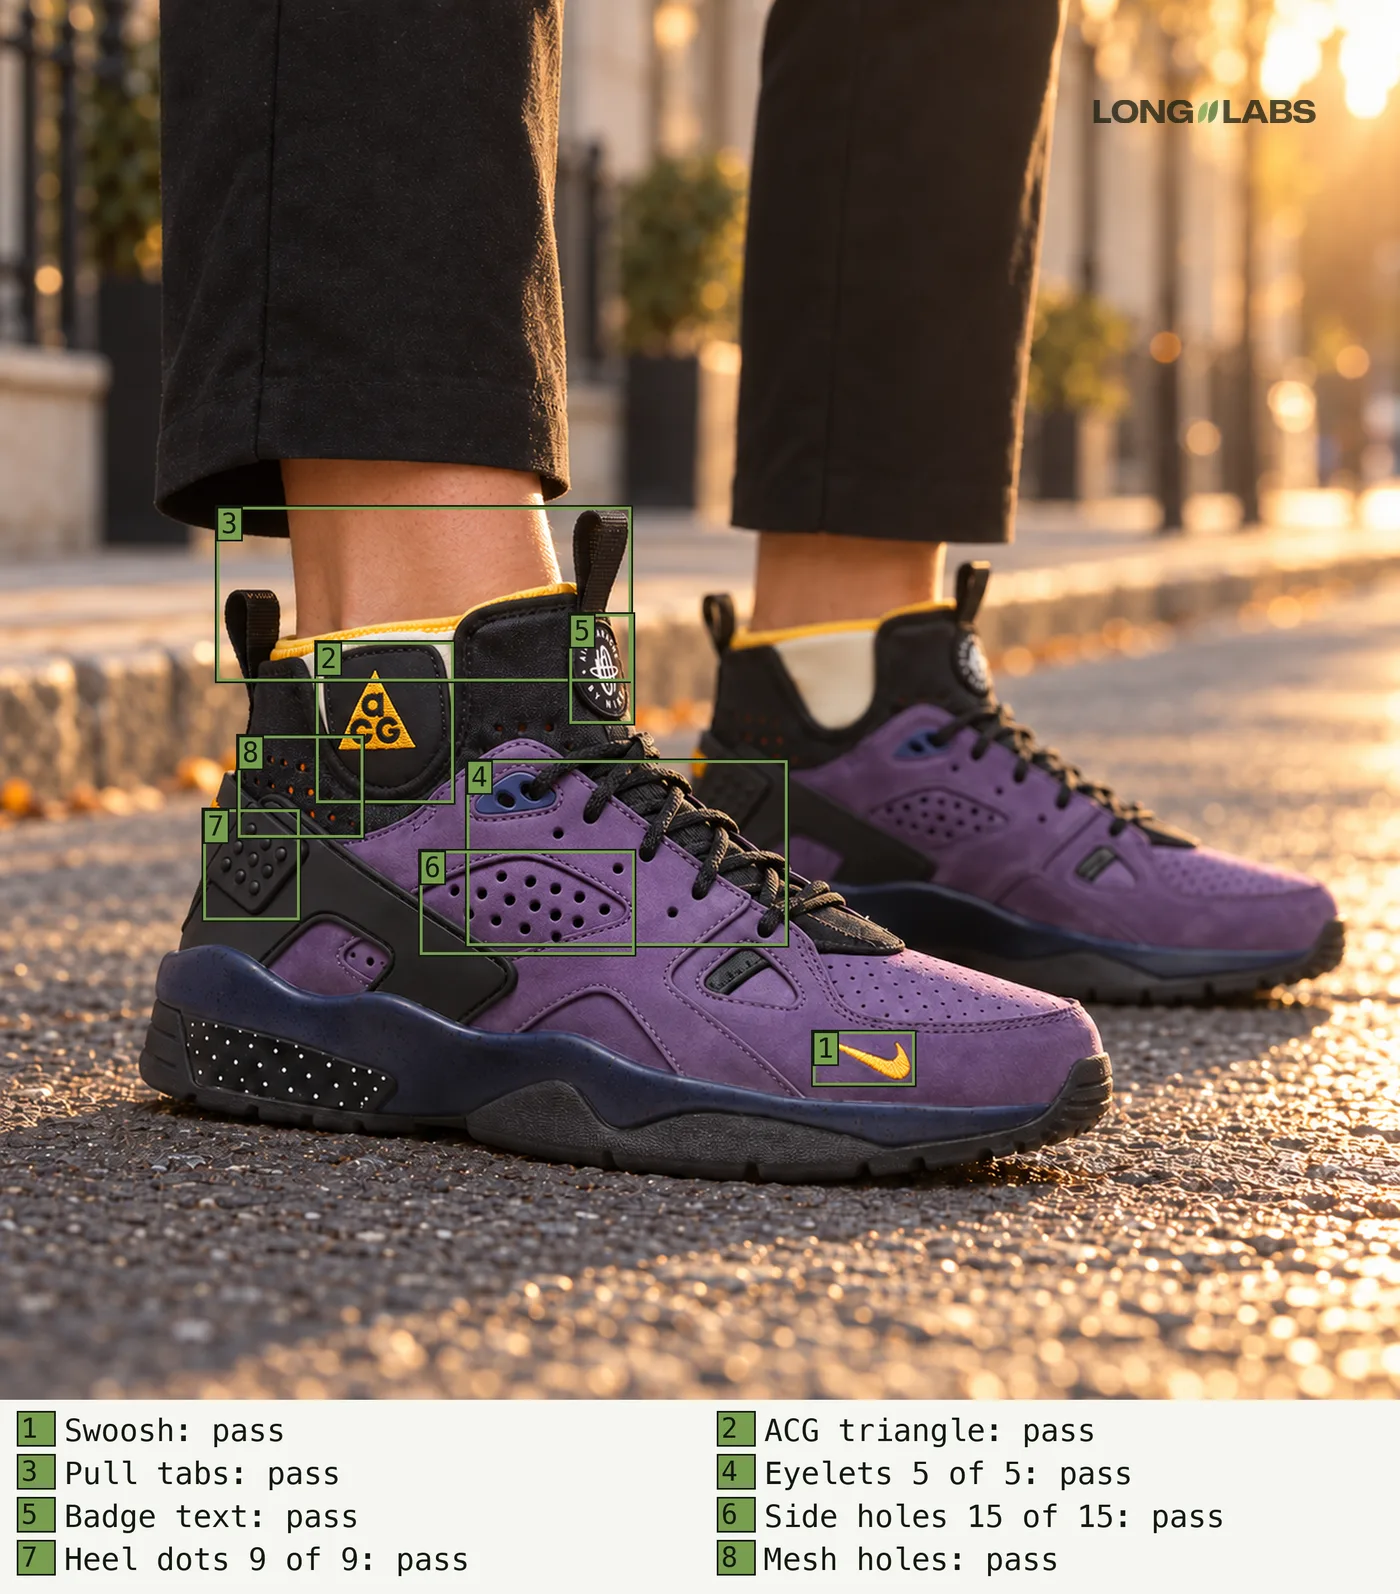
Runde zwei beschrieb jedes Teil in Worten, weiter mit drei Fotos. Auf den ersten Blick besser, aber Laschen und Badge stimmten immer noch nicht, denn drei Fotos ohne gerade Seitenansicht zeigen nicht, wo die Dinge sitzen. Runde drei brachte sechs Blickwinkel und das Datenblatt, und jedes Logo landete auf Anhieb am richtigen Teil. Runde vier brachte acht Nahaufnahmen der Details, und die Zahlen stimmten: 5, 15 und 9. Übrig blieb Kleines und Hartnäckiges: der Badge-Text, die Buchstaben im Dreieckslogo und die Anordnung der Löcher in ihren Reihen.
Runde fünf begann mit einem Audit unserer eigenen Inputs. Wir haben die Ausschnitte aus schärferen Quellbildern neu gemacht, die falsch herum liegenden gespiegelt und zwei Fakten in unserem eigenen Datenblatt korrigiert. Dann kamen die Korrekturen einzeln, jede an einem Ausschnitt in vierfacher Größe und zurück ins ganze Bild gesetzt: die Buchstaben, dann das Badge, dann ein fehlendes Loch.
 Volle Größe ↗
Was auf unserer Seite schiefging
Nicht jede Korrektur hat funktioniert, und manche Fehler lagen bei uns.
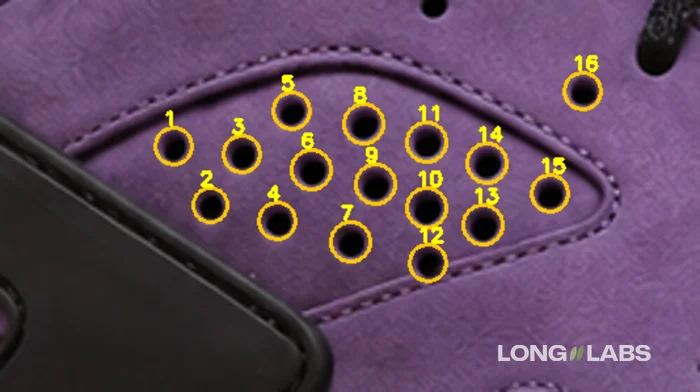
Die erste Bearbeitung des Seitenpanels im ganzen Bild ergab 12 statt 15 Löcher. Das Referenzfoto zeigte in die andere Richtung, also hat das Modell ein gespiegeltes Panel kopiert. Mit gespiegelter Referenz kamen 14 Löcher in Reihen zu 5, 6 und 3. Die Bitte, auf einem Ausschnitt 5, 6 und 4 zu kopieren, ergab einmal 5, 5 und 4 und beim nächsten Mal 5, 6 und 3. Funktioniert hat am Ende die kleinste mögliche Bitte: ein Loch in der unteren Reihe ergänzen. Selbst dann musste ein Loch von Hand geklont werden, im Abstand der eigenen Reihe.
Auch unsere eigene Zählregel war falsch. Ein früher Check meldete 8 Ösen, wo der Schuh 5 hat, weil er die kleinen Perforationen neben den Schnürsenkeln mitzählte. Wir haben die Definition auf Schnürstationen geändert: Öffnungen, durch die wirklich ein Schnürsenkel läuft. Und ein Mensch hat trotzdem gefunden, was jedes Tool übersah: drei kleine Löcher neben jeder Schnürstation außer der letzten, die oberste Station in einem dunkelblauen Beschlag und ein Loch, das außerhalb des Seitenpanels sitzt.
Warum Bildmodelle Zahlen und Logos falsch machen
Unsere Hypothese, keine gemessene Tatsache: Bildmodelle lernen, wie ein Schuh aussieht, nicht seine Teileliste. Ein lila Sneaker mit einem Dreieckslogo irgendwo am Schaft sieht für sie richtig aus, weil er das auf den meisten Fotos tun würde. Wo genau das Logo sitzt, wie viele Löcher es gibt und was auf dem Badge steht, ändert den Gesamteindruck kaum, also hat das Modell wenig Grund, es richtig zu machen.
Am stärksten driften Zahlen. In unseren Läufen lagen sie um eins daneben, bei fünf Ösen genauso wie bei fünfzehn Löchern, egal welche Zahl wir hineinschrieben. Das Modell erzeugt Text als Form, es buchstabiert ihn nicht, also wird aus einem Badge eine Reihe buchstabenähnlicher Zeichen. Und es gibt gern beiden Schuhen eines Paars dieselbe Seite, samt Logos, denn jeder für sich sieht gut aus.
Kann ein Vision-Modell die Prüfung übernehmen? Nicht ab Werk
Jeden Ausschnitt per Auge zu prüfen ist langsam, also haben wir getestet, ob ein Modell das kann. Wir haben acht Nahaufnahmen im selben Bildausschnitt genommen, fünf davon absichtlich beschädigt (ein Loch entfernt, ein Fersenpunkt entfernt, die Logo-Buchstaben verfälscht) und drei Methoden jedes Teil beurteilen lassen.
| Methode | Kaputte Teile freigegeben | Richtige Teile abgelehnt |
|---|---|---|
| Ein Lauf eines Vision-Modells auf dem ganzen Bild, 17 Checks | 6 von 13 (46 Prozent) | 1 von 30 |
| Ein Modell auf einem engen Ausschnitt neben dem echten, ohne erwartete Zahl | 2 von 6 (33 Prozent) | 0 von 8 |
| Ein Pixelzähler, ohne KI | 0 von 3 | 6 von 13, alle Fersenpunkte |
Ab Werk sieht das Modell noch nicht jedes Detail. Der Check auf dem ganzen Bild hat fast die Hälfte der kaputten Teile freigegeben: Er meldete 15 Löcher, nachdem wir eines entfernt hatten, und ließ verfälschte Logo-Buchstaben dreimal durch. Ihm allein zu vertrauen funktioniert nicht.
Was hilft, sind bessere Augen. Sagen Sie ihm Teil für Teil, was es erwarten soll, aus dem Datenblatt. Zeigen Sie ihm einen engen Ausschnitt neben demselben Ausschnitt des echten Schuhs statt des ganzen Bildes. Und stellen Sie Computer Vision daneben, die einfach zählt: Der Pixelzähler hat nie ein kaputtes Teil freigegeben. Er sieht keine Punkte, die kein Licht fangen, und lehnt deshalb gute Bilder ab, und das ist die sichere Art, falschzuliegen. Wenn Zähler und Modell sich widersprechen, schaut ein Mensch hin.
Der echte Test: ein Kampagnen-Shooting und die zwei Bilder, die die QA stoppte
Fünf Runden an einer Nahaufnahme sind ein Laborergebnis. Also haben wir mit demselben Paar eine kleine Kampagne fotografiert: eine Person, ganzer Körper, drei Posen, der Schuh klein im Bild. Das hält viel besser als Runde eins. Trotzdem hatten zwei der drei Bilder ein Logo, wo das echte Paar keins hat.
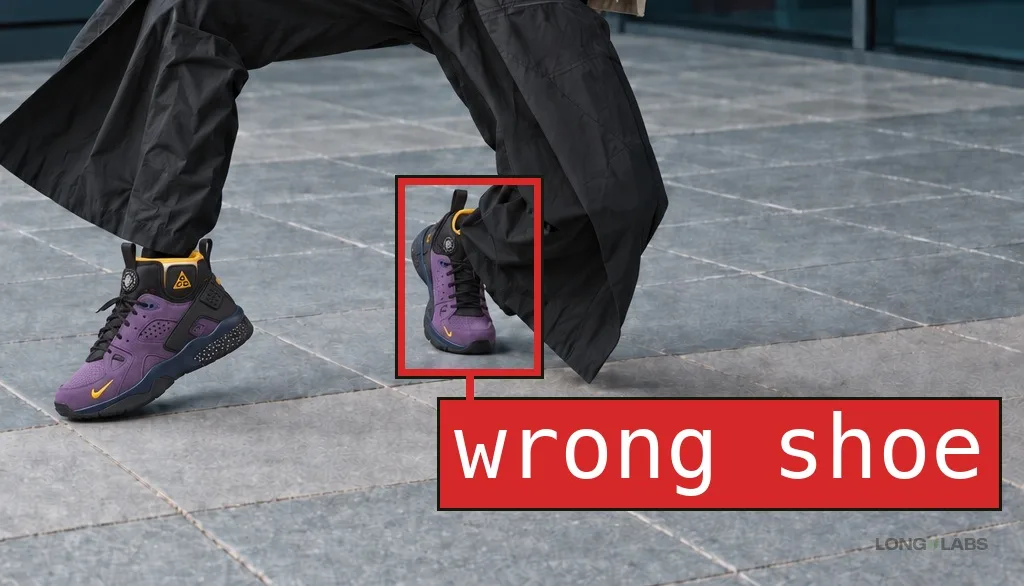
Auf dem ersten trägt der rechte Fuß einen anderen Schuh: die Form eines Laufschuhs, das Seitenlogo an der Spitze der Innenseite, mehr als fünf Ösen. Der Check auf einem engen Ausschnitt beider Füße hat es gefunden.
Das zweite ist schwerer zu sehen. Auf einer Bank sitzend zeigen beide Füße in dieselbe Richtung, die Kamera sieht also die Außenseite des einen Schuhs und die Innenseite des anderen. Das echte Paar trägt das Dreieckslogo nur am äußeren Kragen. Im Bild zeigen es beide. Der Check hat es durchgelassen. Ein Mensch hat es im letzten Blick gefunden, bevor etwas rausgeht, und genau dafür gibt es diesen Blick.
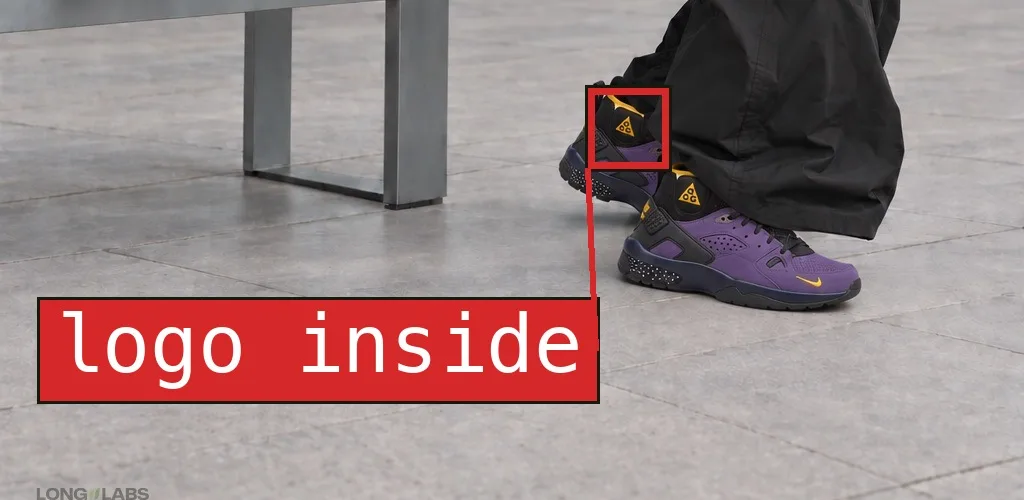
Genau dafür ist QA da. Keines der Bilder geht raus, beide gehen mit dem Grund zurück:
| Schritt | Was passiert |
|---|---|
| Erstellen | Der Prompt, die Teileliste und Fotos des echten Schuhs. |
| Prüfen | Jedes Teil von nah, neben dem echten Schuh. Software zählt. |
| Ein Mensch gibt frei | Ein letzter Blick auf jedes Bild, bevor es rausgeht. Hier fand er das Logo auf der Innenseite. |
| Zurückschicken | FLAG mit dem Grund, hier: ein anderer Schuh am rechten Fuß, ein Logo auf der Innenseite. |
| Neu erstellen | PASS erst, wenn jedes Teil den Check und den Menschen erneut besteht. |
Ein Prompt bringt Sie nah heran. Ein Check findet den Rest.
Wie wir KI-Produktbilder jetzt prüfen
Der Ablauf passt auf eine Karteikarte. Nichts daran ist raffiniert, er lässt nur keinen Schritt aus.
1. Das echte Produkt von allen Seiten fotografieren, dazu Nahaufnahmen jedes kleinen Details.
2. Das Datenblatt schreiben: jedes Teil, wo es im Verhältnis zu einem anderen sitzt, jede Zahl mit ihrer Zählregel, jeder Text Buchstabe für Buchstabe.
3. Mit allen Fotos im Anhang generieren, die riskanten Teile im Prompt ausgeschrieben.
4. Jedes Teil auf einem engen Ausschnitt neben dem echten Foto prüfen. Zahlen: zuerst ein Pixelzähler, dann ein Modell, dann ein Mensch, wenn sie sich widersprechen.
5. Eine Sache nach der anderen korrigieren, an einem Ausschnitt in vierfacher Größe, dann zurück ins ganze Bild.
6. Erneut prüfen. Verdeckt oder unscharf heißt unsicher, nie bestanden.
Der Prompt, den wir genutzt haben, als Vorlage. Hängen Sie die Fotos von allen Seiten an und füllen Sie ihn für Ihren Schuh aus. Er bringt die Positionen in Ordnung. Zahlen und kleinen Text löst er allein nicht, die brauchen weiter den Check:
The reference photos show the [shoe] from every side plus close-ups of every detail. Copy it exactly, do not redesign:
1. [Main logo]: [colour, size], on [which side and part]. Nowhere else.
2. [Second logo or badge]: on [its part]. Not on [where AI puts it].
3. [Tabs or straps]: [how many], [flat or rope].
4. Eyelets: exactly [number] per side.
5. [Holes or dots]: exactly [number] in [rows].
6. A left shoe and a right shoe, mirror images.
No extra logos, no changed colours.
Und der Prompt zur Fehlersuche, den wir als zweites Paar Augen nutzen. Erst die echten Fotos, das KI-Bild zuletzt. Auf unseren 8 Testbildern fand er 4 der 5 eingebauten Fehler. Den entfernten Fersenpunkt hat er übersehen, nehmen Sie seine Antwort also als Liste von Stellen, an denen Sie hinschauen:
I attach photos of a real shoe and one AI image of the same shoe. The LAST image is the AI image. All other images are real photos.
Shoe type: [your shoe type, for example casual lace-up sneaker].

Find every place where the AI image does not match the real shoe. Work in this order:
1. From the real photos, list every part a buyer could check: each logo and the side it sits on, every badge or label and its exact text, everything you can count (eyelets, holes, dots, studs, straps, hooks) and how it is arranged, the sole, the heel, the material, the pair (one left, one right).
2. Find each part in the AI image. Look at that region up close in both images side by side, not at the whole picture.
3. Counts: count in the real photo and in the AI image separately, one item at a time, row by row. Do not decide in advance what the number should be. Then check the pattern spot by spot: for every position in the real pattern, is there an item in the same spot in the AI image? An empty, flat or smeared spot is a FAIL. If you cannot see every item clearly, the answer is UNSURE.
4. Text and logos: for each letter, first describe its strokes in the real photo (closed bowl, stem, tail, bar), then the same letter in the AI image. A missing stroke, a letter that turned into another letter, or a smeared letter is a FAIL. A logo that is missing, moved or added is a FAIL. If the letters are too small to describe stroke by stroke, the answer is UNSURE, never PASS.
5. Then shape, material, pair, ground contact and toes if a foot shows.

Answer with one line per part:
part | where | real photo | AI image | PASS, FAIL or UNSURE | why
Only write PASS when you saw the part clearly and it matches. Hidden, blurry or too small to read is UNSURE, never PASS.
End with one line: VERDICT: FIX (any FAIL), CHECK BY EYE (any UNSURE) or LOOKS RIGHT. Then list what a person still has to check by eye.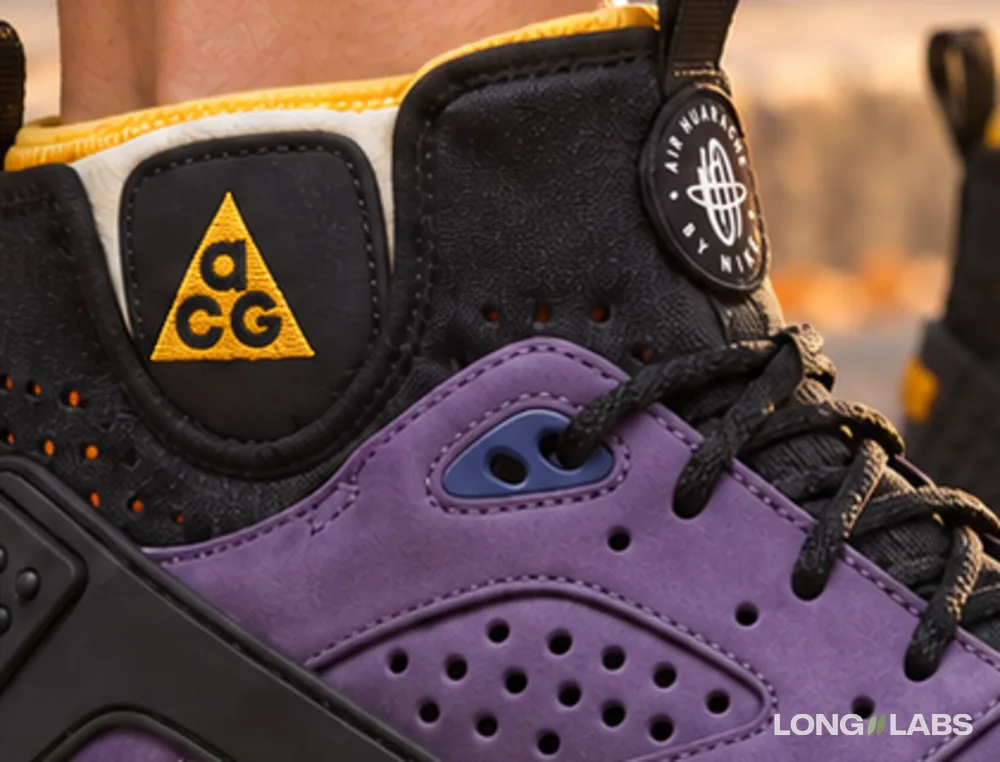
Grenzen dieses Tests
- Ein Schuh, ein Bildausschnitt, eine prüfende Person. Das zeigt, wo KI-Schuhbilder brechen und wie wir sie reparieren, nicht wie oft.
- Der Benchmark sind 8 Bilder mit 5 eingebauten Fehlern, je ein Lauf. Die Prozente zeigen eine Richtung, keine Quoten.
- Das Datenblatt ist zwischen den Runden gewachsen (12, 16, dann 17 Punkte), die Werte pro Runde sind also sichtbare Checks dieser Runde, kein fester Test.
- Zwei der 17 Punkte sind im finalen Winkel verdeckt. Sie gelten als unsicher, nicht als bestanden.
- Der Kampagnen-Check umfasst 3 Bilder, per Auge. So klein im Bild lassen sich Löcher gar nicht zählen, nur Logos, Form und das Paar. Der Check hat eines der zwei gestoppten Bilder übersehen, der Mensch hat es gefunden.
- Ein Loch wurde von Hand geklont, ein Prompt allein hat es nicht geschafft. Farbe unter anderem Licht, Material und Passform lassen sich an einem Bild gar nicht prüfen.
So funktioniert es
- Produkt
- ein lila Mid-Top-Sneaker, unser eigenes Paar ist die Wahrheit
- Referenzen
- 9 Produktfotos der Marke, lokal genutzt, nicht veröffentlicht
- Datum
- 2026-10-22
- Wie bewertet wird
- jedes Teil auf einem engen Ausschnitt neben dem echten Foto, per Auge; ein Pixelzähler und Vision-Modelle als Helfer
FAQ
Kann ich die Zahlen einfach in den Prompt schreiben?
Ja, schreiben Sie sie immer hinein. Aber in unseren Läufen lagen Zahlen trotzdem um eins daneben, bei fünf Ösen genauso wie bei fünfzehn Löchern. Zählen Sie jedes Bild per Auge.
Warum nicht ein Vision-Modell prüfen lassen?
Ab Werk sieht es nicht jedes Detail. In unserem Test gab ein Lauf auf dem ganzen Bild 6 von 13 kaputten Teilen frei. Geben Sie ihm das Datenblatt und enge Ausschnitte, stellen Sie einen Pixelzähler daneben, und lassen Sie bei Widerspruch einen Menschen entscheiden.
Brauche ich Fotos des echten Produkts?
Ja, von allen Seiten. Mit drei Fotos ohne gerade Seitenansicht landete das Logo am falschen Teil des Schuhs.
Funktioniert das auch für andere Produkte als Schuhe?
Die Methode ist dieselbe für alles mit Teilen, die man zählen oder lesen kann: Knöpfe, Nähte, die Beschläge einer Tasche, die Armlehnen eines Sofas. Gemessen haben wir sie bisher nur an diesem Schuh.